ШІ в Україні хочуть врегулювати за європейським зразком: що це означає
У Верховній Раді готують законопроєкт про штучний інтелект, орієнтований на європейський AI Act. Медіа закликають не чекати ухвалення закону й маркувати ШІ-контент уже тепер.
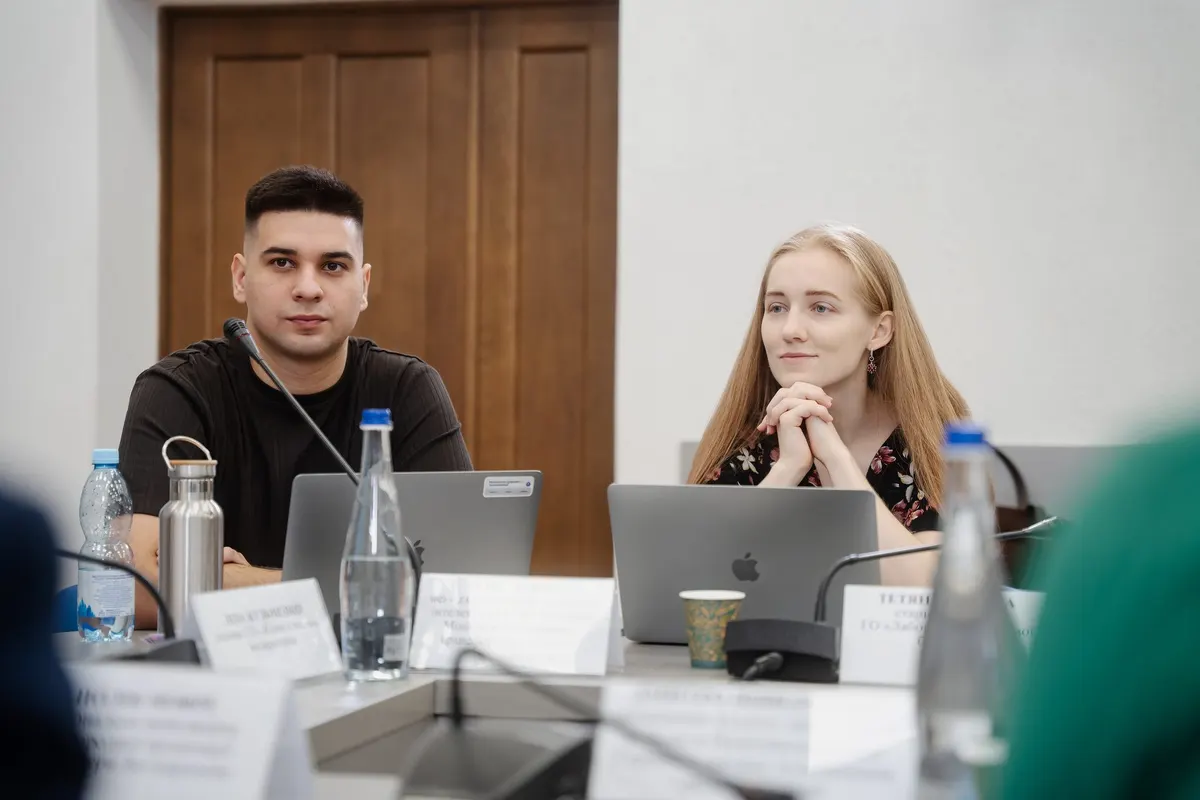
Над документом працює робоча група при парламентському Комітеті з питань цифрової трансформації — до неї входять понад 150 людей. Про це під час круглого столу «Від експериментів до стандартів: етичне використання ШІ в українських редакціях», організованого ГО «Жінки в медіа», розповів менеджер напряму штучного інтелекту Мінцифри Олег Дубно.
За його словами, синхронізація українського законодавства про ШІ з нормами ЄС — один із бенчмарків, який Єврокомісія офіційно комунікує з Україною. «Прийняття законодавства у сфері штучного інтелекту, яке буде синхронізоване із законодавством ЄС, є одним з бенчмарків, який Єврокомісія офіційно комунікує з нами», — сказав він. Дубно нагадав, що Мінцифри ще 2023 року запустило дорожню карту регулювання ШІ та підготувало перші секторальні рекомендації для медіа. Він також закликав редакції вже зараз впроваджувати підходи до маркування згенерованого контенту, які вимагає Євросоюз, замість того щоб чекати на ухвалення закону.
Старша юристка Лабораторії цифрової безпеки Тетяна Авдєєва зауважила, що певне регулювання в Україні вже існує — окремими нормами різних законів. Зокрема, стаття 33 закону «Про авторське право» визначає, як використовувати не оригінальні об’єкти, створені комп’ютерними системами. «Тобто, по суті, у нас уже є базове регулювання у сфері захисту прав інтелектуальної власності. Є певні принципові обмеження на кшталт заборони мови ворожнечі, захисту прав дітей. Наприклад, якщо текст, згенерований ШІ, не вичитаний, він може містити слюри, упередження, те, що вже заборонене національним законодавством. Зображення можуть бути такими, що поширюються на аудиторію 16+ або 18+. Ймовірно, це може підпадати також під порушення ст. 42 ЗУ "Про медіа"», — пояснила вона.
Про власні труднощі розповіла керівниця етико-правового напрямку проєкту з розвитку української великої мовної моделі (LLM) «Сяйво» Олена Андрієнко. За її словами, найскладніше — шукати баланс у використанні чутливої лексики та тем, що стосуються мобілізації, евакуації й переселенців. «Мовна модель повинна бути збалансованою, але, разом з тим, не допускати мови ворожнечі, проявів ненависті тощо. Вона має працювати так, аби це було не лише юридично правильно, відповідало загальнолюдським принципам, а також відповідало тій ситуації, яку ми маємо тут і тепер», — сказала Андрієнко. Вона наголосила: використання національної моделі — це питання державної безпеки, тож усі нюанси мають бути враховані.
У дискусії взяли участь також представники загальнонаціональних, регіональних і локальних медіа, Національної ради з питань телебачення і радіомовлення та інші фахівці галузі. Говорили про те, як редакціям екологічно використовувати ШІ, про етичні аспекти такого контенту та про реакцію на поширення згенерованих матеріалів у соцмережах. Цьогоріч «Жінки в медіа» розробили шаблон політики використання штучного інтелекту в редакціях і практичну інструкцію щодо її впровадження. За підсумками проєкту власні політики використання ШІ вже затвердили «Рубрика», «Український тиждень», Starlight Media, «Frontliner», «Ґвара Медіа», Радіо «Накипіло» та газета «Вість».
Читайте також

Ще в розділі «Політика»
- ТСК хоче привести керівництво фонду, де заброньований ексміністр Федоров, до Ради примусово
- Сеул відмовив Києву у зброї: ППО Україна не отримає
- США завершують вихід з Іраку: останні війська покинуть країну до 30 вересня
- Львів проситиме уряд про гроші на відновлення після атак РФ
- Швейцарія вперше вдарила санкціями по оборонці РФ: хто в списку